Multimodal: Text, Image និង Audio
 by Sot Dimong
១២ កញ្ញា ២០២៦
បញ្ចូលប្រភេទ Input ផ្សេងៗ និងបញ្ជាក់អ្វីត្រូវសង្កេត អ្វីត្រូវប្រៀបធៀប និង Output ចង់បាន។
Gemini Mission • Level 2
🌈 Multimodal Explorer
សេចក្តីផ្តើមមេរៀន
មេរៀនទី៦ ៖ «Multimodal: Text, Image និង Audio» នឹងណែនាំអ្នកឱ្យយល់ច្បាស់ពី បញ្ចូលប្រភេទ Input ផ្សេងៗ និងបញ្ជាក់អ្វីត្រូវសង្កេត អ្វីត្រូវប្រៀបធៀប និង Output ចង់បាន។
មេរៀនទី៦ ៖ «Multimodal: Text, Image និង Audio» នឹងណែនាំអ្នកឱ្យយល់ច្បាស់ពី បញ្ចូលប្រភេទ Input ផ្សេងៗ និងបញ្ជាក់អ្វីត្រូវសង្កេត អ្វីត្រូវប្រៀបធៀប និង Output ចង់បាន។
១. ស្ថាបត្យកម្ម Native Multimodal ៖ ពេល Text, Image និង Audio រួមបញ្ចូលគ្នា
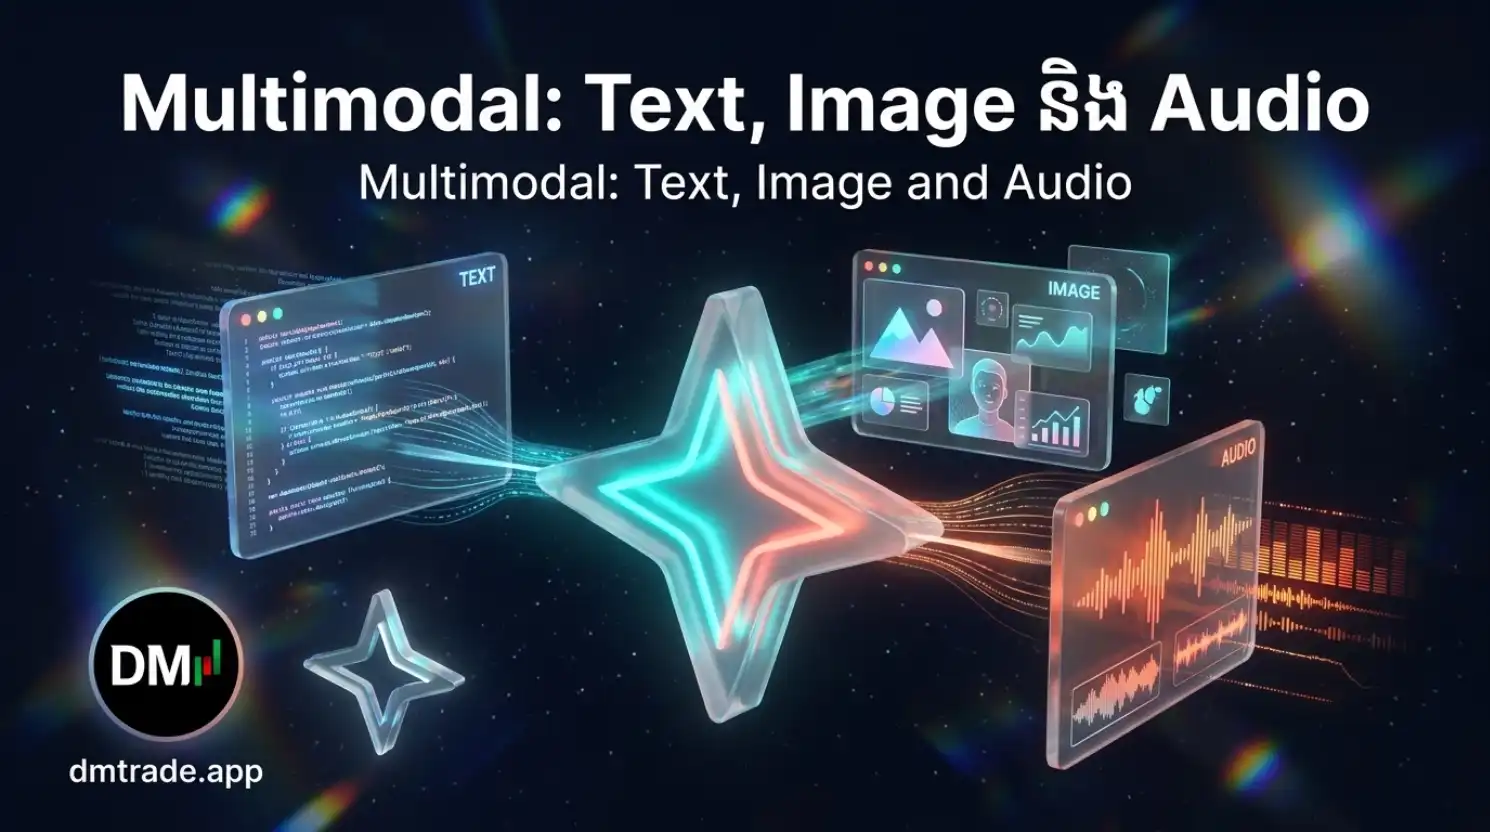
Google Gemini គឺជា Native Multimodal AI ជំនាន់ដំបូងគេបង្អស់លើពិភពលោក ដែលមិនមែនគ្រាន់តែបំប្លែងរូបភាព ឬសំឡេងទៅជាអក្សរមុននឹងឆ្លើយនោះទេ។ ផ្ទុយទៅវិញ នៅក្នុង Neural Network តែមួយ Gemini អាចទទួលយក ប្រភេទ Input ចម្រុះ (Mixed-Modal Inputs) ព្រមគ្នា៖ អត្ថបទបញ្ជា (Text), រូបថត ឬ Screenshot (Image), និងសំឡេងកត់ត្រាផ្ទាល់មាត់ (Audio Notes)។
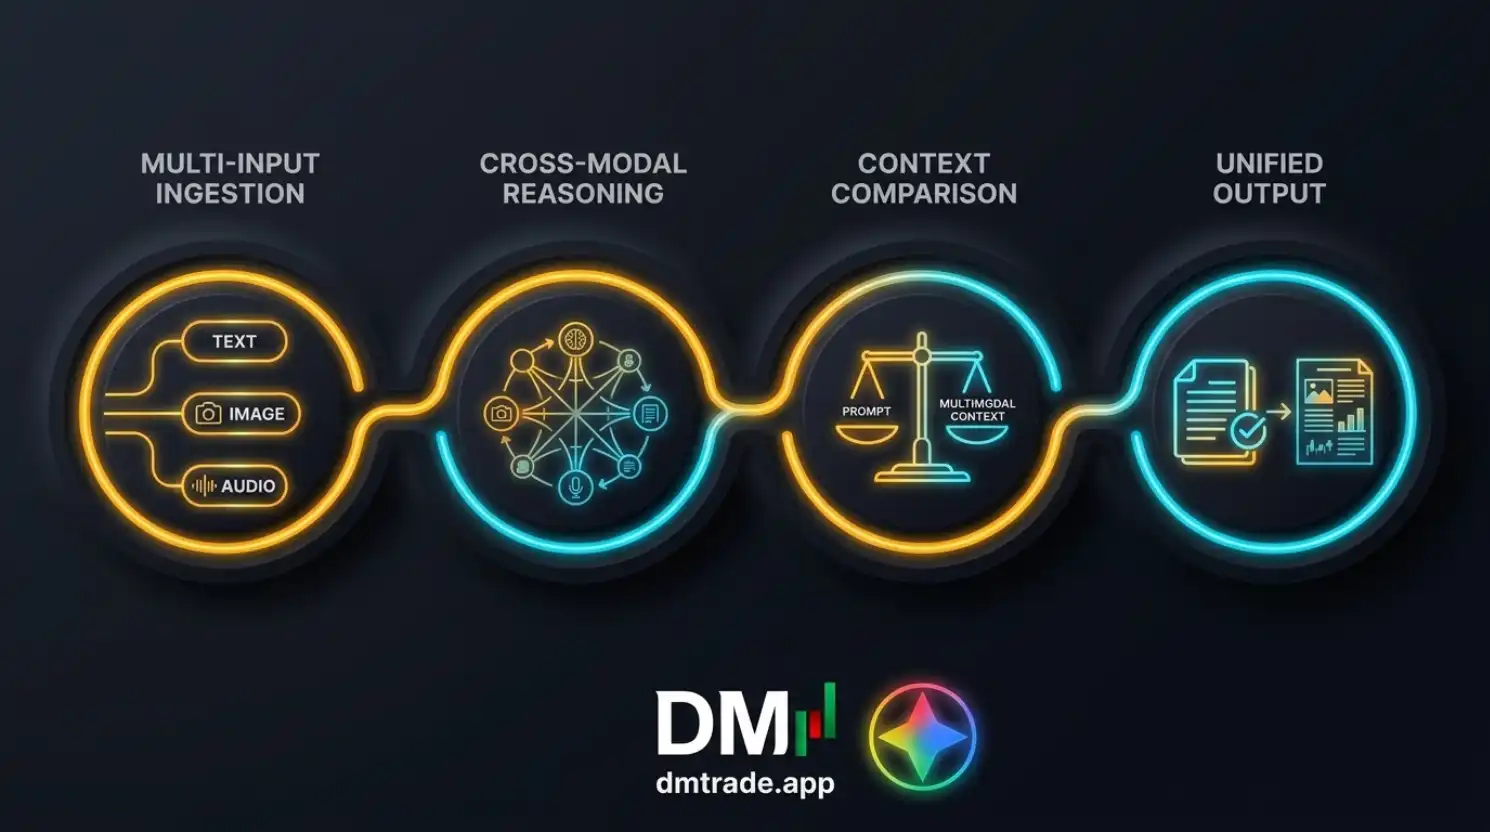
កំហុសដ៏ធំបំផុតរបស់អ្នកប្រើប្រាស់ទូទៅ គឺការបញ្ចូលរូបភាព ឬសំឡេងចូលទៅក្នុង AI ដោយគ្មានការបញ្ជាក់ច្បាស់លាស់។ ដើម្បីទាញយកថាមពល Multimodal ឱ្យអស់ពីលទ្ធភាព អ្នកត្រូវអនុវត្តតាម រូបមន្ត ៣ ជំហាន (Observe, Compare, Output)៖
- បញ្ជាក់អ្វីត្រូវសង្កេត (Specify What to Observe)៖ ចង្អុលបង្ហាញឱ្យ AI មើលទៅលើតំបន់ជាក់លាក់ណាមួយ (ឧ. «សូមក្រឡេកមើលតារាងតម្លៃនៅជ្រុងខាងស្តាំនៃរូបភាពនេះ»)។
- បញ្ជាក់អ្វីត្រូវប្រៀបធៀប (Specify What to Compare)៖ ប្រសិនបើមាន Input ច្រើន ត្រូវបញ្ជាក់ពីទំនាក់ទំនង (ឧ. «សូមប្រៀបធៀបតួលេខលើរូបវិក្កយបត្រនេះ ជាមួយសំឡេងដែលខ្ញុំបាននិយាយក្នុង Audio Clip»)។
- បញ្ជាក់ Output ដែលចង់បាន (Specify Desired Output)៖ កំណត់ទម្រង់ចម្លើយឱ្យច្បាស់លាស់ (ឧ. «បង្ហាញលទ្ធផលជាតារាង Markdown Table ដោយមានជួរឈរ៖ ធាតុ, តម្លៃក្នុងវិក្កយបត្រ, ការបកស្រាយក្នុងសំឡេង»)។
២. ករណីសិក្សាជាក់ស្តែងទាំង ៤ នៃការប្រើប្រាស់ Multimodal Inputs
ការរួមបញ្ចូល Text, Image និង Audio បង្កើតបានជាដំណោះស្រាយការងារដ៏មានឥទ្ធិពល៖
វិក្កយបត្រ + សំឡេងកត់ត្រា (Expense Tracking)៖
Upload រូបថតវិក្កយបត្រសាំង រួចផ្ញើសំឡេងនិយាយខ្លីៗ៖ «នេះជាការចំណាយលើបេសកកម្មខេត្តសៀមរាប» → Gemini រៀបចំតារាងចំណាយភ្ជាប់ទាំងរូបភាព និងកំណត់ចំណាំ។
Screenshot + Error Text (Visual Debugging)៖
ភ្ជាប់រូបថតអេក្រង់ Error នៃ Website រួមជាមួយ Code Snippet → Gemini ចង្អុលបង្ហាញកូដ CSS ដែលខូច និងណែនាំកូដកែតម្រូវ។
Chart Image + Strategy Audio (Market Analysis)៖
បញ្ចូលរូបភាពក្រាហ្វិកតម្លៃមាស រួចសួរដោយបញ្ជាក់លក្ខខណ្ឌ៖ «សូមពិនិត្យមើលចំណុច Resistance និងណែនាំផែនការជួញដូរ»។
Wireframe Drawing + Design Prompt (UI Prototyping)៖
ថតរូបគំនូរព្រាងប្លង់ App ដោយដៃលើក្រដាស រួចបញ្ជា Gemini ឱ្យសរសេរកូដ Frontend HTML/CSS តាមប្លង់នោះភ្លាមៗ។
៣. បច្ចេកទេស Prompting សម្រាប់ Multimodal Inputs
ដើម្បីទទួលបានលទ្ធផលកម្រិតខ្ពស់ពី Multimodal Input អ្នកគួររៀបចំ Prompt តាមលំដាប់លំដោយដូចខាងក្រោម៖
- Context & Role៖ កំណត់តួនាទី (ឧ. «អ្នកជាអ្នកជំនាញវិភាគទិន្នន័យពាណិជ្ជកម្ម»)。
- Input Breakdown៖ រៀបរាប់ពី Input ដែលបានភ្ជាប់ (ឧ. «ខ្ញុំបានភ្ជាប់រូបភាពតារាងលក់ប្រចាំខែ និងឯកសារសំឡេងសង្ខេបរបស់អ្នកគ្រប់គ្រង»)。
- Observation Tasks៖ បញ្ជាក់អ្វីដែលត្រូវសង្កេត និងគណនា (ឧ. «១. ស្រង់តួលេខលក់សរុប, ២. កត់ត្រាបញ្ហាប្រឈមដែលបានរៀបរាប់ក្នុងសំឡេង»)。
- Output Format៖ កំណត់ទម្រង់ចុងក្រោយ (ឧ. «ផ្តល់ទម្រង់ជាតារាង Markdown Table អមដោយ Executive Summary ៣ ចំណុច»)。
គន្លឹះគុណភាពរូបភាព និងសំឡេង៖ ត្រូវប្រាកដថារូបភាពមានពន្លឺគ្រប់គ្រាន់ មិនព្រាល (Blur) និងសំឡេងគ្មានសម្លេងរំខានខ្លាំងពេក ដើម្បីឱ្យ Gemini ដំណើរការ Tokens បានត្រឹមត្រូវ ១០០%។
៤. ការប្រៀបធៀប៖ ការសួរ Multimodal ទូទៅ vs ការសួរមានការចង្អុលបង្ហាញ
ចូរពិនិត្យមើលភាពខុសគ្នារវាងការបញ្ជាខ្វះទិសដៅ និងការបញ្ជាកម្រិតវិជ្ជាជីវៈ៖
៥. គោលការណ៍សុវត្ថិភាព និងការការពារទិន្នន័យឯកជនភាព
នៅពេលបញ្ចូលរូបភាព និងសំឡេងចូលទៅក្នុង Gemini សូមប្រុងប្រយ័ត្នខ្ពស់ចំពោះ PII (Personally Identifiable Information)។ ជៀសវាងការ Upload រូបថតដែលមានជាប់លេខអត្តសញ្ញាណប័ណ្ណ លេខកាតធនាគារ ឬសំឡេងសន្ទនាផ្ទាល់ខ្លួនដែលមានព័ត៌មានរសើប។
Google អនុវត្តច្បាប់តឹងរ៉ឹង៖ Gemini មិនធ្វើការកំណត់អត្តសញ្ញាណមុខមាត់មនុស្សទូទៅ (No Facial Recognition on private citizens) ដើម្បីការពារសិទ្ធិឯកជនភាព។
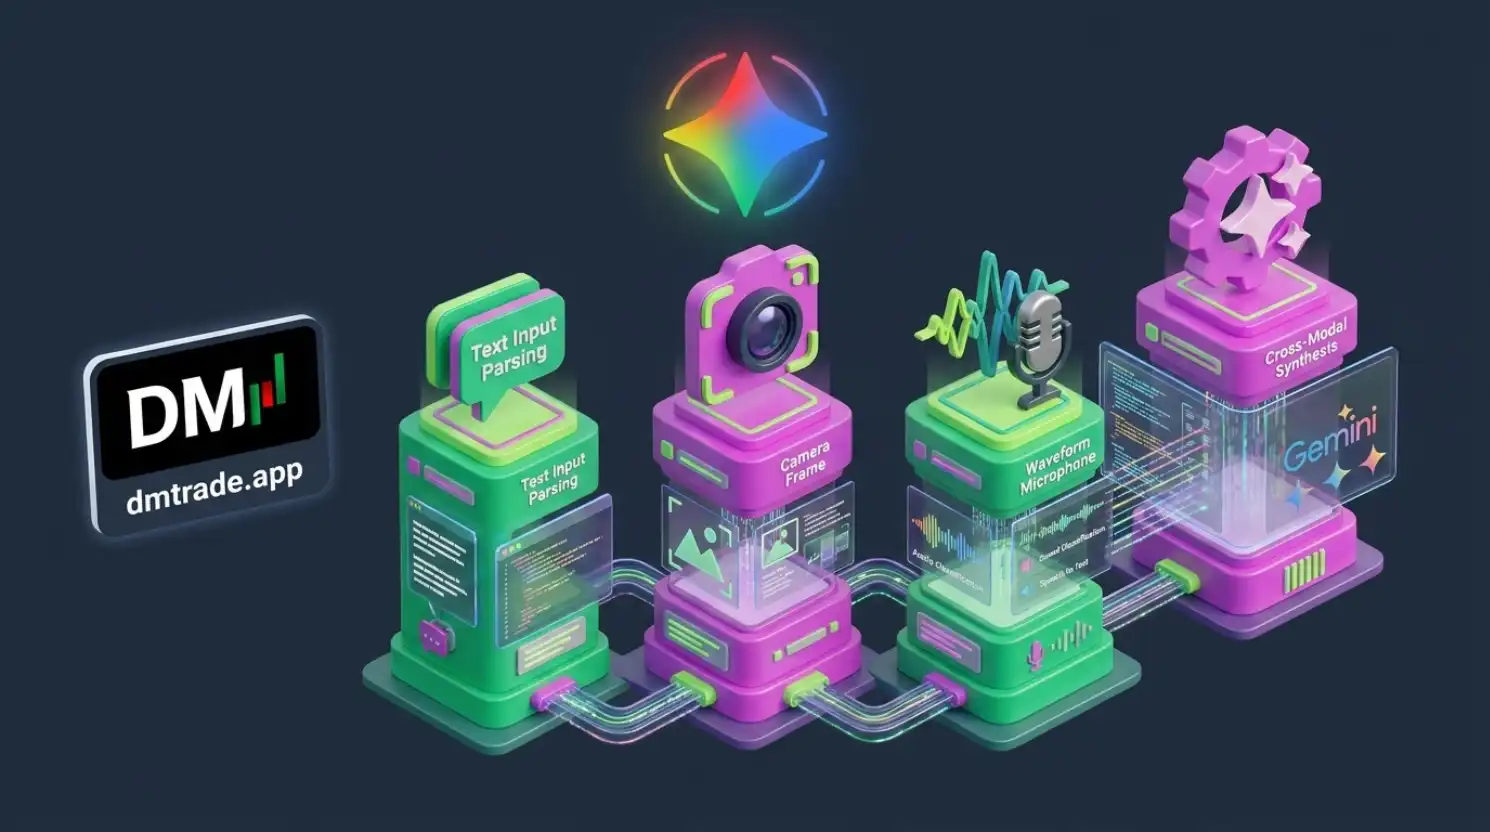
Live Gemini Lab • Multimodal Ingestion Studio
សាកល្បងជ្រើសរើសប្រភេទចម្រុះនៃ Input ខាងក្រោមដើម្បីមើលពីរបៀបដែល Gemini ដំណើរការទិន្នន័យ Multimodal ព្រមគ្នា។
លទ្ធផលគំរូ៖ Gemini ផ្គូផ្គងលេខវិក្កយបត្រ $145 ជាមួយសំឡេងបញ្ជាក់ «ថ្លៃអាហារទទួលភ្ញៀវក្រុមហ៊ុន» រួចចាត់ថ្នាក់ចំណាយចូលទៅក្នុងប្រភេទ Entertainment Expense ដោយស្វ័យប្រវត្តិ។
៦. លំហាត់អនុវត្ត PROMPT លើ GEMINI
អនុវត្តតាមរូបមន្តអាជីព៖ ROLE (តួនាទី) → CONTEXT (បរិបទ) → CONSTRAINTS (ដែនកំណត់) → FORMAT (ទម្រង់ចម្លើយ)។
ផ្អែកលើរូបថតបង្កាន់ដៃទូទាត់ និងកំណត់ចំណាំជាសំឡេងដែលខ្ញុំបានភ្ជាប់មកនេះ សូមបំពេញកិច្ចការ ៣ ជំហាន៖ ១. ពិនិត្យសង្កេតតួលេខតម្លៃសរុប និងកាលបរិច្ឆេទលើរូបភាព។ ២. ប្រៀបធៀបជាមួយសំឡេងកត់ត្រាដើម្បីដឹងពីគោលបំណងនៃការចំណាយ។ ៣. បង្កើតតារាង Markdown Table ដែលមាន៖ កាលបរិច្ឆេទ, ឈ្មោះទំនិញ, តម្លៃ, និងគណនីចំណាយ។
៧. ពិនិត្យការយល់ដឹង (QUIZ)
នៅពេលប្រើប្រាស់ Gemini ជាមួយ Multimodal Inputs (រូបភាព និងសំឡេង) តើអ្វីជាកត្តាសំខាន់បំផុតដើម្បីទទួលបានចម្លើយសុក្រឹត?
✓ ត្រឹមត្រូវឥតខ្ចោះ! រូបមន្ត Observe + Compare + Desired Output គឺជាគន្លឹះមាសក្នុងការទាញយកសមត្ថភាពពិតនៃ Native Multimodal AI របស់ Gemini។
៨. ចំណុចសំខាន់ដែលត្រូវចងចាំ
- Gemini គឺជា Native Multimodal ដែលយល់ Text, Image, និង Audio ព្រមគ្នាក្នុង Neural Network តែមួយ។
- អនុវត្តរូបមន្ត ៣ ជំហាន៖ បញ្ជាក់អ្វីត្រូវសង្កេត, អ្វីត្រូវប្រៀបធៀប, និងទម្រង់ Output ចង់បាន។
- ការពារទិន្នន័យឯកជនភាព និងជៀសវាងការ Upload ព័ត៌មានអត្តសញ្ញាណផ្ទាល់ខ្លួនដែលមិនបាន Mask។
អនុសាសន៍អនុវត្ត៖ យកទ្រឹស្តីក្នុងមេរៀនទី៦នេះ ទៅសាកល្បងជាមួយកិច្ចការងារជាក់ស្តែងរបស់អ្នកថ្ងៃនេះភ្លាមៗ ដើម្បីបង្កើនល្បឿន និងភាពស្ទាត់ជំនាញ។
GEMINI EXPLORER BADGE
កំពុងបង្កើតជំនាញ Gemini របស់អ្នក
បន្តអានគ្រប់ Checkpoint និងឆ្លើយ Quiz ដើម្បីបើកស្ថានភាព Mission Complete របស់អ្នក។
សូមត្រៀមខ្លួនសម្រាប់មេរៀនបន្ទាប់៖ «មេរៀនទី៧ ៖ Upload Files និង Long Documents»។